稳定的差异化科研倾向。
我们训练「联、构、品、创、谨」等不同科研倾向的专业小语言模型,让团队长期保持不同的观察角度、判断习惯和审查方式,而不是依靠同一个通用模型反复生成相似答案。
不是让一个 AI 回答问题,而是让一支科研智能体团队围绕同一个研究目标持续协作。它们结合企业已有的实验、资料和研究历史,检索证据、形成判断、发现分歧,并帮助科研人员推进下一步研究。
 联系体验使用 ↗
我们训练「联、构、品、创、谨」等不同科研倾向的专业小语言模型,让团队长期保持不同的观察角度、判断习惯和审查方式,而不是依靠同一个通用模型反复生成相似答案。
前沿大模型承担复杂推理、任务执行与信息综合;AlphaFold、结构预测、分子设计等专业科学模型则作为工具按需调用。不同能力各自做擅长的事情,再由团队共同完成科研任务。
小模型提供稳定的差异化科研倾向,大模型提供更强的通用推理,专业模型提供确定性的科学计算。
公共知识可以重新搜索,但一家企业自己的研究历史无法从互联网上重新获得。
多智能体团队可以在企业已有的实验、证据和研究决策之上继续工作,让新的研究继承过去的 Context。
Scientific Artifact 和 MCP 不是另一套产品,而是让团队进入真实科研工作流的接口。
Scientific Table
Scientific Image
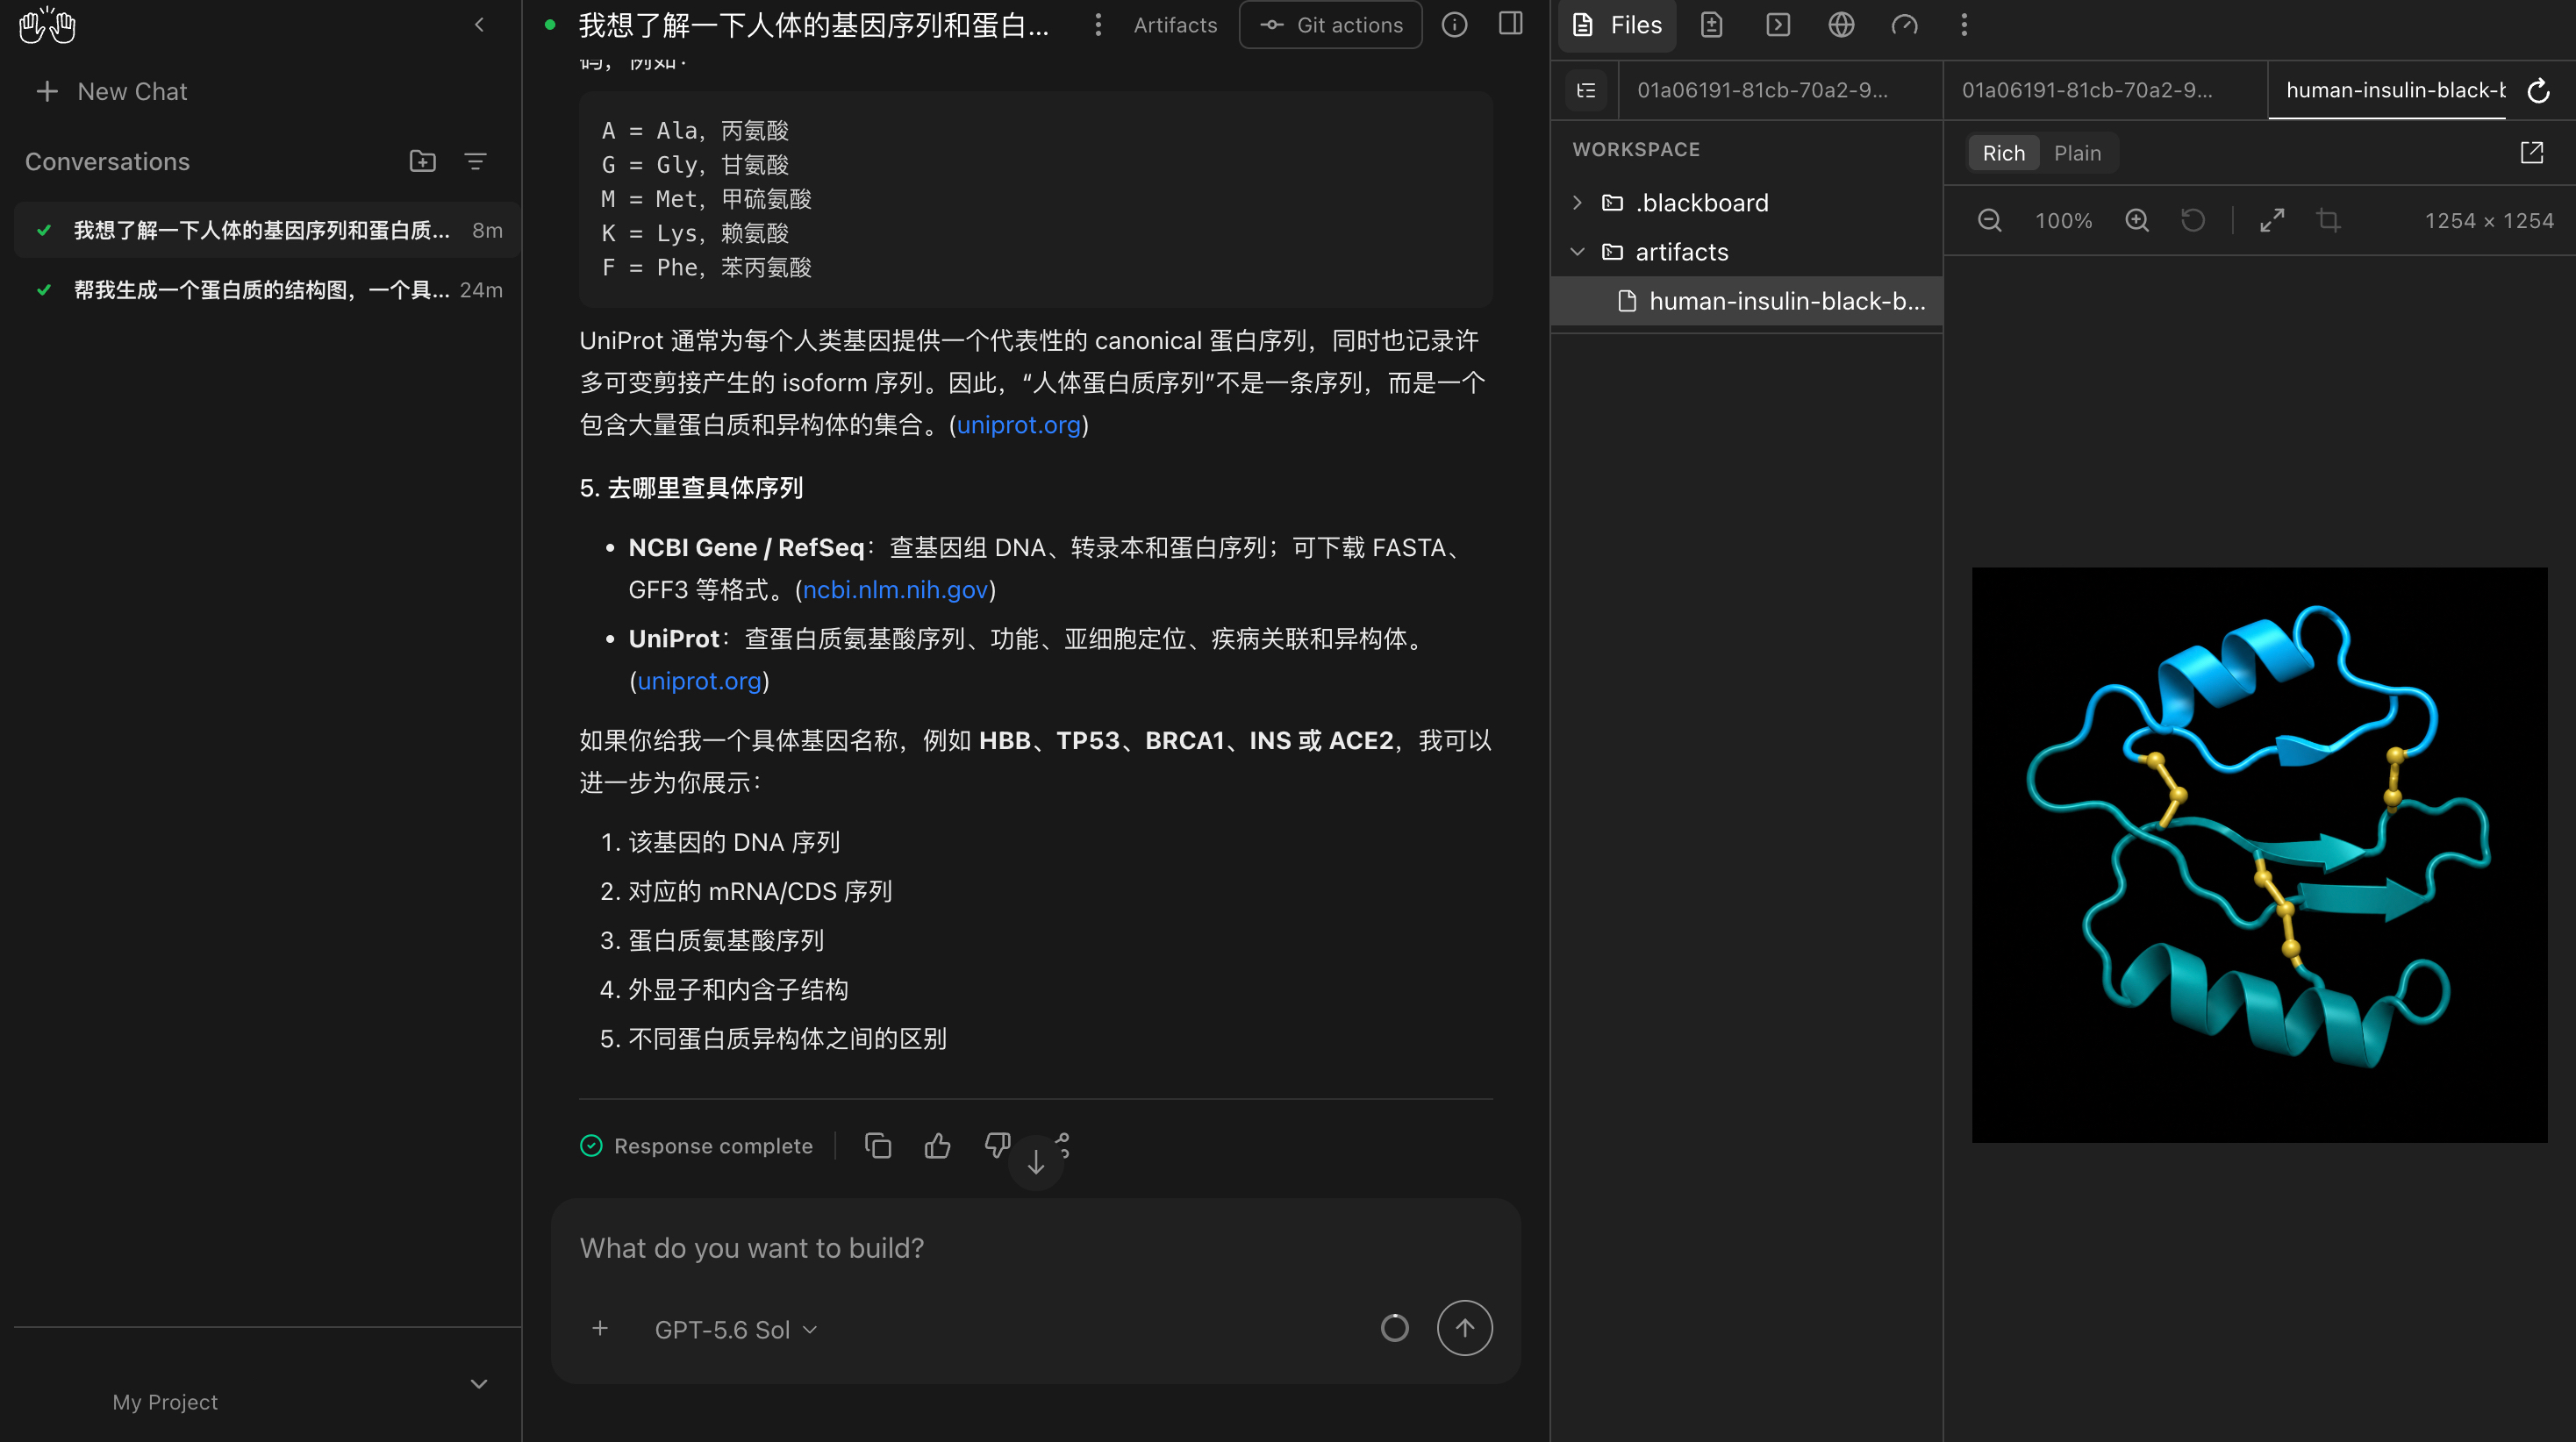
Protein Structure
Molecule
实验表格、科研图像、蛋白结构和分子可以直接成为团队的工作上下文;对于科研人员已经依赖的专业软件,则通过 MCP 和工具接口连接,而不是重新复制一套软件。
看到什么,就直接和 Ligase 讨论什么。团队在同一个上下文里检索、分析和复核,再把确认过的结果带回企业研究历史。
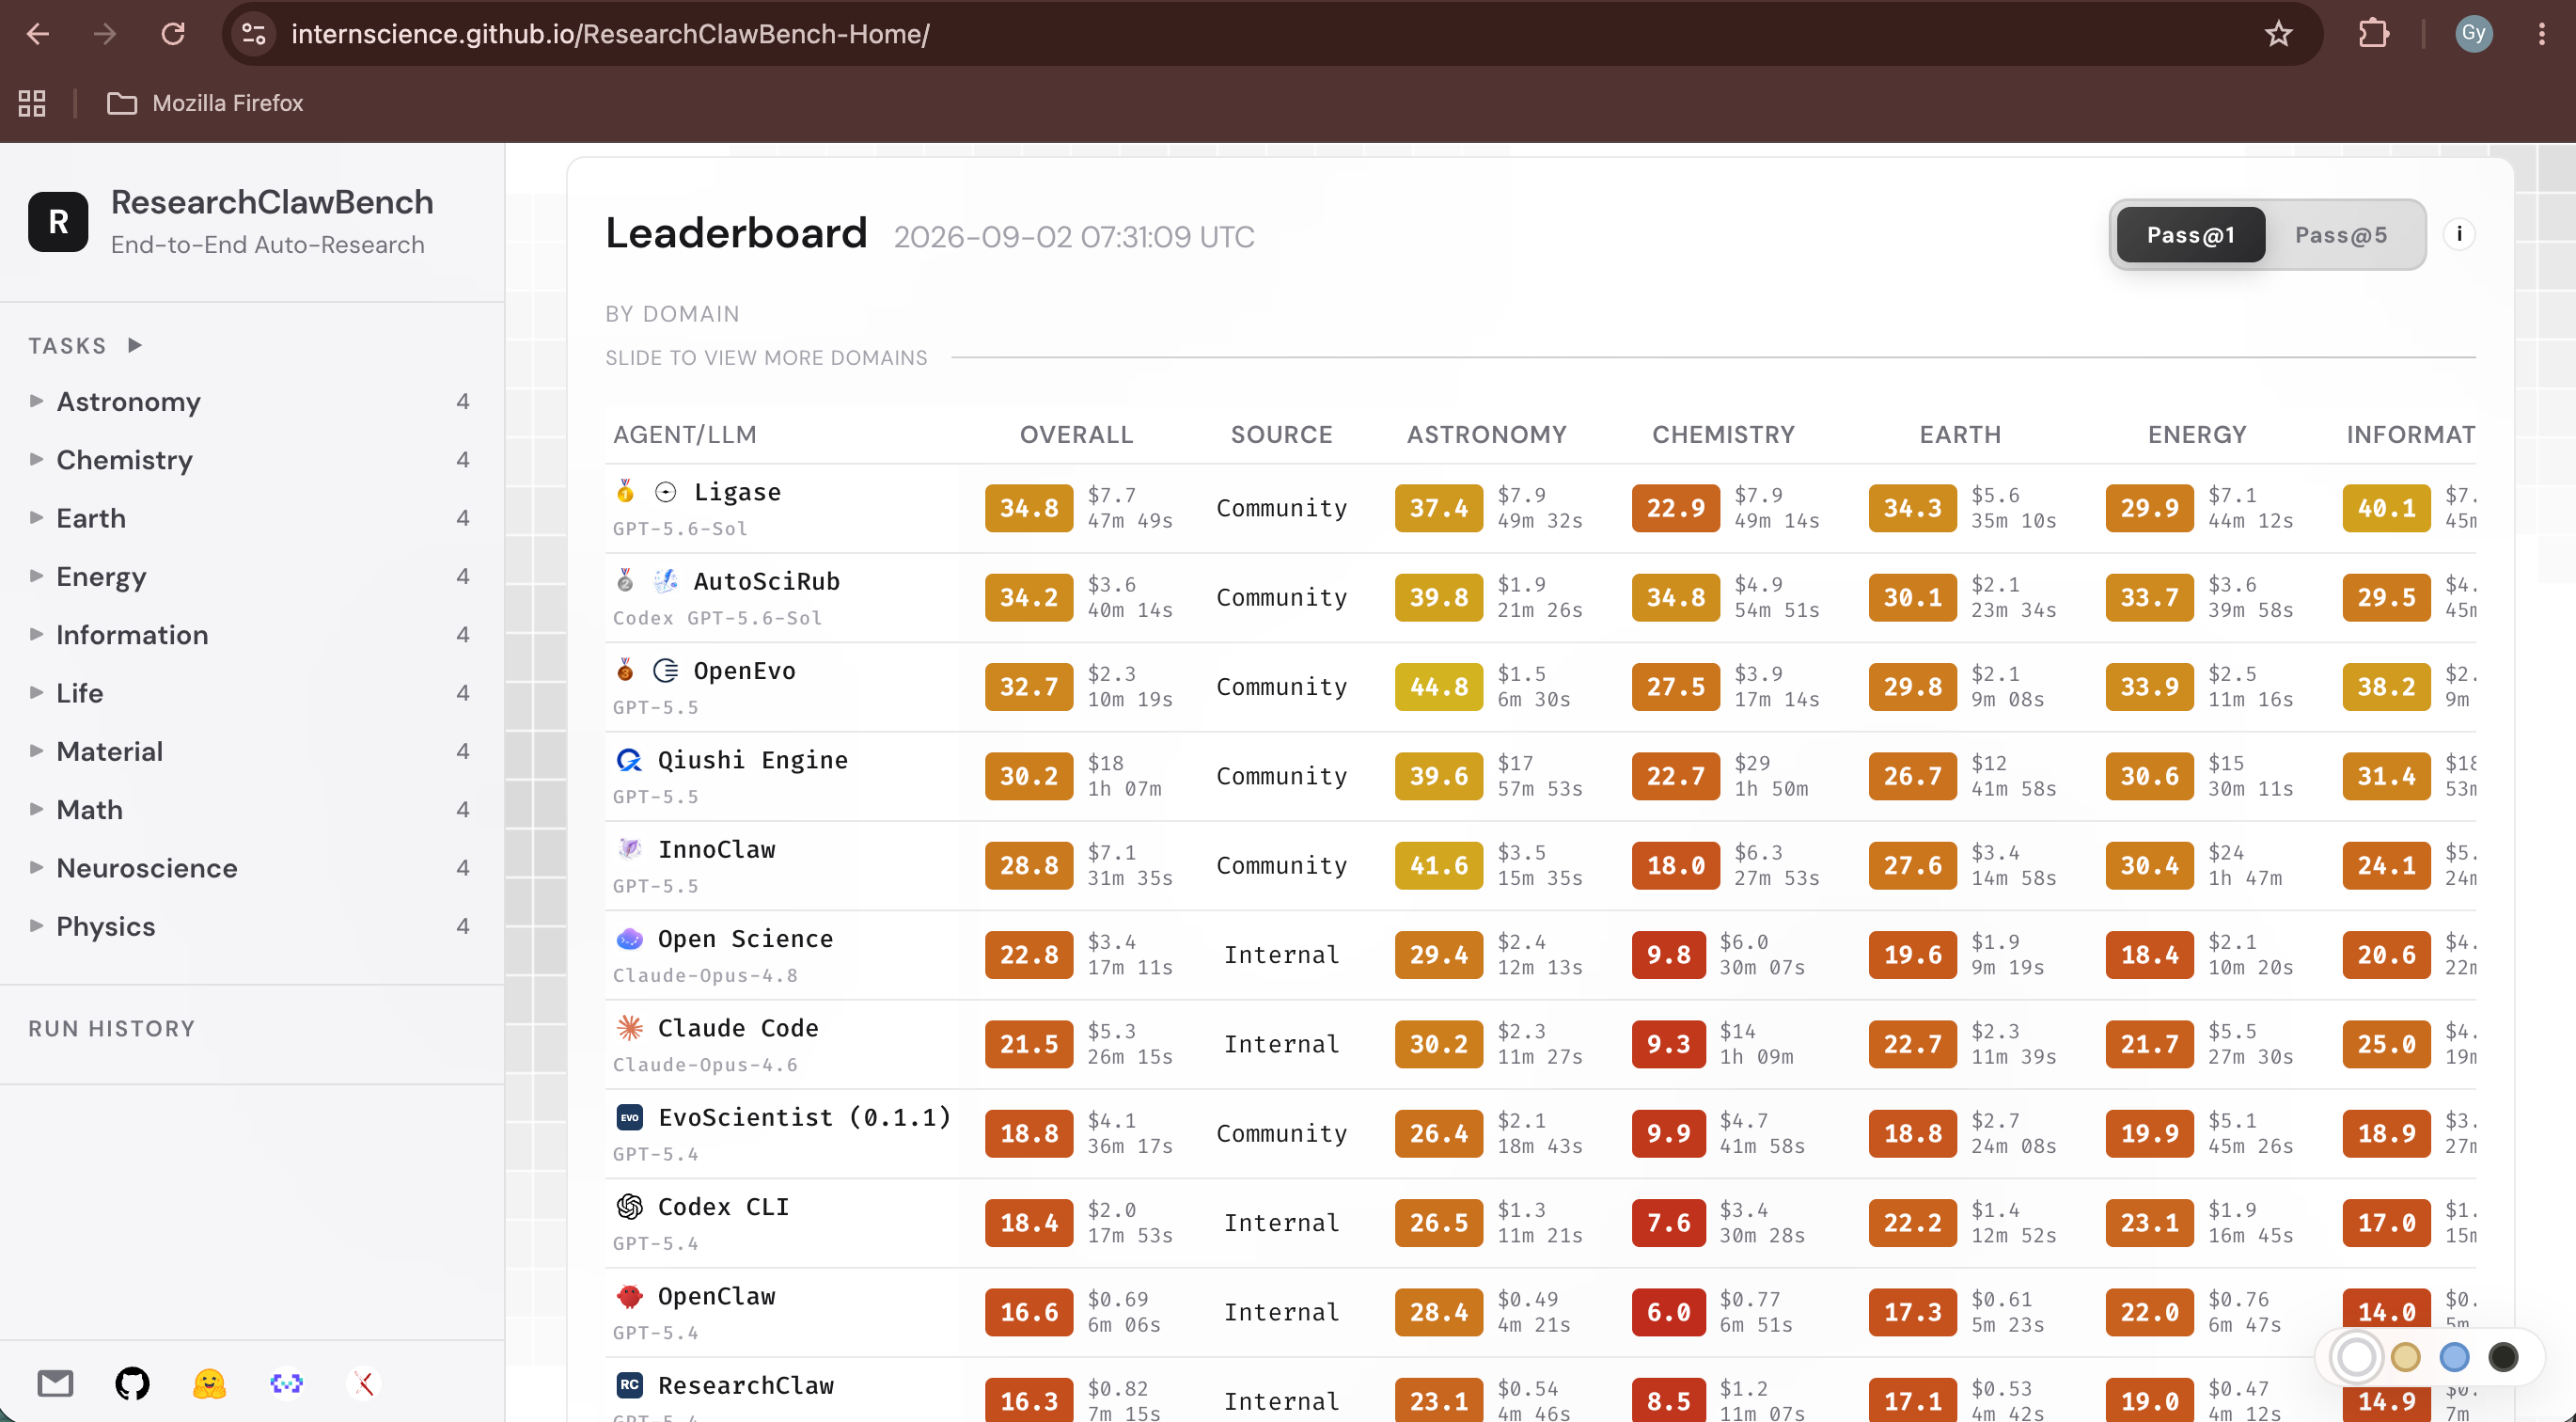
联系体验使用ResearchClawBench 面向端到端自动研究能力,按多个真实科研领域进行公开评测。当前官方榜单显示,Ligase 以 Pass@1 Overall 34.8 位列第 1 名。
 打开官方榜单 ↗
榜单当前标注为 Ligase · GPT-5.6-Sol。它评估检索、分析、工具调用与结果交付组成的完整自动研究过程。
榜单会持续更新,页面成绩以 ResearchClawBench 官方入口为准。